Nos últimos anos, a Inteligência Artificial deixou de ser um conceito restrito a laboratórios de pesquisa e passou a fazer parte do cotidiano de empresas, desenvolvedores e usuários comuns. Entre as tecnologias que mais contribuíram para essa transformação estão os LLMs (Large Language Models), ou Grandes Modelos de Linguagem.
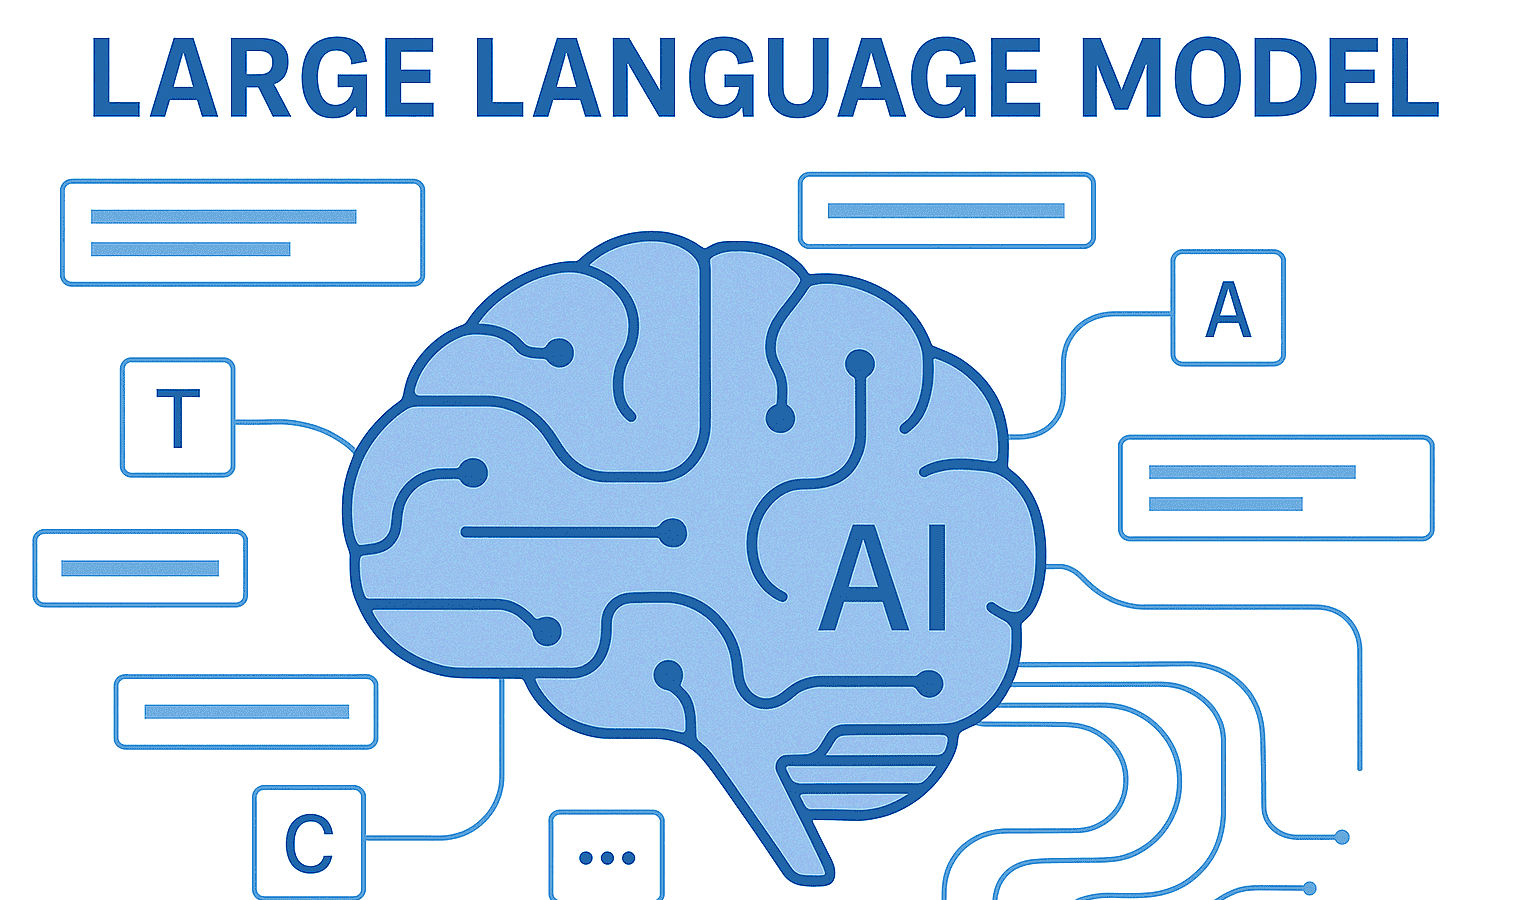
Mas o que exatamente é um LLM? De forma simples, podemos dizer que é um modelo de inteligência artificial treinado com grandes volumes de dados textuais para compreender e gerar linguagem humana. Ele consegue analisar uma pergunta, identificar padrões no texto e produzir uma resposta que, em muitos casos, parece ter sido escrita por uma pessoa.
Como um LLM funciona?
Para entender um LLM, primeiro é importante compreender que ele não funciona como um banco de dados tradicional. Ele não simplesmente procura uma resposta armazenada e a apresenta ao usuário.
Durante o treinamento, o modelo recebe uma enorme quantidade de textos e aprende padrões relacionados às palavras, frases, conceitos e estruturas da linguagem. Um dos principais objetivos desse processo é prever quais elementos de texto têm maior probabilidade de aparecer em determinado contexto.
Por exemplo, ao receber a frase:
“JavaScript é uma linguagem de…”
o modelo consegue identificar padrões aprendidos durante o treinamento e prever que palavras como “programação” ou “programação de alto nível” podem completar a frase.
Modelos modernos utilizam arquiteturas baseadas em Transformers, uma tecnologia que permite analisar diferentes partes de uma sequência de texto e compreender melhor a relação entre elas. O mecanismo de atenção, conhecido como attention, é fundamental para esse processo.
O que significa “treinar” um LLM?
O treinamento de um LLM exige uma quantidade enorme de dados e poder computacional. O modelo começa com parâmetros que não possuem conhecimento útil sobre linguagem. Durante o treinamento, ele processa exemplos e ajusta esses parâmetros para reduzir seus erros.
Imagine que o modelo receba:
“O Brasil fica localizado na América…”
e precise prever a próxima palavra. Ao longo de bilhões de exemplos, ele aprende que determinadas palavras e conceitos aparecem relacionados entre si.
Esse processo não significa que o modelo “entenda” o mundo exatamente como um ser humano entende. O que ele possui é uma representação matemática extremamente complexa dos padrões encontrados nos dados utilizados durante seu treinamento.
LLM não é simplesmente um chatbot
Um ponto importante é diferenciar LLM de chatbot.
Um LLM é o modelo de linguagem que consegue processar e gerar texto. Já um chatbot é uma aplicação que utiliza esse modelo para interagir com o usuário.
Por isso, uma aplicação pode utilizar um LLM para muito mais do que conversar. Ele pode ser usado para geração de código, resumo de documentos, tradução, classificação de textos, análise de informações, criação de conteúdo e diversas outras tarefas.
Na prática, podemos imaginar uma arquitetura em que o usuário envia uma solicitação para uma aplicação, a aplicação processa essa solicitação e então utiliza um LLM para gerar uma resposta.
O papel dos LLMs no desenvolvimento de software
Para desenvolvedores, os LLMs abriram novas possibilidades.
Eles podem auxiliar na criação de funções, explicar código, encontrar possíveis problemas, gerar testes, documentar APIs e até ajudar na arquitetura de sistemas.
Por exemplo, um desenvolvedor trabalhando com Node.js pode descrever uma funcionalidade em linguagem natural e solicitar uma implementação. O modelo pode gerar uma primeira versão do código, que posteriormente será revisada e adaptada pelo profissional.
Isso não significa que o desenvolvedor deixou de ser necessário. Pelo contrário: quanto mais complexa a aplicação, mais importante se torna saber avaliar o código produzido, entender seus impactos e validar se a solução realmente atende aos requisitos.
O LLM funciona melhor como uma ferramenta de amplificação da capacidade humana do que como um substituto automático para conhecimento técnico.
Context Window e Tokens
Dois conceitos importantes para compreender LLMs são tokens e context window.
Tokens são unidades utilizadas pelo modelo para representar o texto. Uma palavra pode corresponder a um token ou ser dividida em várias partes, dependendo do modelo e do sistema de tokenização.
Já a context window representa a quantidade de informação que o modelo consegue considerar dentro de uma determinada interação.
Isso é importante porque um LLM não possui necessariamente acesso ilimitado a todo o histórico de uma conversa. Quanto maior a janela de contexto, maior a quantidade de informações que pode ser considerada simultaneamente, embora isso dependa das características do modelo.
As limitações dos LLMs
Apesar de suas capacidades, LLMs possuem limitações importantes.
Uma delas é a possibilidade de gerar informações incorretas apresentadas de maneira convincente. Esse comportamento é frequentemente chamado de alucinação.
Por isso, respostas geradas por um LLM não devem ser automaticamente consideradas verdadeiras. Em aplicações críticas, é necessário implementar mecanismos de validação, acesso a fontes confiáveis e regras que reduzam a possibilidade de erros.
Outro desafio é a dependência dos dados utilizados no treinamento. Um modelo pode reproduzir padrões, erros ou vieses presentes nesses dados.
Além disso, conhecimento, raciocínio e acesso a informações atualizadas são questões diferentes. Um LLM pode ser excelente em linguagem e ainda assim precisar de ferramentas externas para consultar informações em tempo real.
RAG e ferramentas externas
Uma das formas de ampliar a utilidade de um LLM é utilizar arquiteturas como RAG (Retrieval-Augmented Generation).
Em vez de depender exclusivamente do conhecimento aprendido durante o treinamento, o sistema pode buscar informações em documentos, bancos de dados ou outras fontes antes de gerar a resposta.
Imagine uma empresa que possui milhares de documentos internos. Em vez de treinar novamente um LLM com todos esses documentos, uma aplicação pode localizar os trechos relevantes e enviá-los como contexto para o modelo.
Isso permite criar sistemas capazes de responder perguntas utilizando informações específicas da organização.
O futuro dos LLMs
Os LLMs representam uma mudança importante na maneira como interagimos com computadores. Durante décadas, a comunicação com sistemas dependia principalmente de interfaces, comandos e linguagens específicas.
Agora, podemos utilizar a linguagem natural como uma interface para diversas tarefas.
Isso não significa que todas as aplicações serão substituídas por IA. Na realidade, a tendência é que LLMs sejam incorporados a sistemas existentes, funcionando como uma nova camada de inteligência.
O grande diferencial não estará apenas em utilizar um LLM, mas em saber como integrá-lo corretamente a uma aplicação. Segurança, custo, qualidade dos dados, contexto, avaliação das respostas e integração com ferramentas externas serão fatores fundamentais.
No final, compreender LLMs não significa apenas saber conversar com uma inteligência artificial. Significa entender uma nova camada da computação, na qual linguagem natural, software e modelos de inteligência artificial passam a trabalhar juntos.
Para desenvolvedores, essa mudança representa uma oportunidade: aprender a utilizar LLMs não apenas como usuários, mas como componentes de sistemas reais, capazes de resolver problemas de negócio e ampliar as possibilidades do software.